Tracking server-side : arbitrer précision, coûts et conformité
Le tracking server-side promet de récupérer du signal, mais il déplace surtout les responsabilités
Le tracking server-side est devenu l’un des sujets les plus sensibles des équipes marketing orientées performance. La promesse est claire : réduire les pertes de mesure liées aux bloqueurs publicitaires, aux restrictions navigateurs, aux cookies tiers en déclin, aux consentements fragmentés et aux scripts client-side trop instables. Dans un environnement où les décisions d’acquisition reposent sur le CPA, coût par acquisition, c’est-à-dire le coût marketing nécessaire pour générer un client ou une conversion qualifiée, et sur le ROAS, return on ad spend, ratio entre chiffre d’affaires attribué et dépenses publicitaires, récupérer quelques points de signal peut sembler immédiatement rentable.
Mais le sujet est plus complexe qu’un simple déplacement de tags du navigateur vers un serveur. Le tracking server-side consiste à faire transiter une partie des événements de mesure par un serveur contrôlé par l’entreprise ou par un prestataire, plutôt que de les envoyer directement depuis le navigateur vers les plateformes analytics, publicitaires ou CRM. En théorie, cette architecture améliore la qualité des données, réduit la dépendance aux scripts tiers et permet d’enrichir, filtrer ou normaliser les événements avant transmission. En pratique, elle crée aussi de nouveaux arbitrages : coût d’infrastructure, gouvernance des données, conformité RGPD, qualité de déduplication, latence, dépendance à des API et risque de sur-confiance dans une mesure toujours imparfaite.
Pour une équipe CRO, conversion rate optimization, discipline qui vise à améliorer la capacité d’un parcours digital à transformer son trafic en valeur business, l’enjeu n’est pas seulement technique. Le tracking server-side influence la lecture du funnel, parcours allant de la première exposition marketing à la conversion puis à la fidélisation. Il modifie les données transmises aux plateformes média, donc les algorithmes d’enchères. Il peut changer l’attribution, méthode qui assigne une conversion à un ou plusieurs points de contact marketing. Il peut également faire apparaître une hausse des conversions mesurées sans que la valeur incrémentale réelle augmente. Le risque est alors de confondre récupération de mesure et création de performance.
La bonne question n’est donc pas : faut-il passer au server-side ? La bonne question est : quels événements méritent ce niveau d’investissement, quelle précision additionnelle peut réellement améliorer les décisions, quel coût total faut-il accepter, et sous quelles conditions juridiques et analytiques le dispositif reste défendable ? Un tracking server-side mature n’est pas un moyen de contourner les restrictions de consentement. C’est une architecture de mesure plus contrôlée, qui doit être conçue pour préserver la confiance dans les décisions marketing.
Identifier les pertes de signal avant de choisir une architecture
La première erreur consiste à décider d’un déploiement server-side parce que le marché le présente comme une évolution naturelle du tracking. Avant de migrer, il faut quantifier les pertes de signal actuelles. Toutes les organisations ne subissent pas les mêmes pertes, et toutes les pertes ne justifient pas les mêmes investissements. Un site média avec 45 % de refus de consentement, un e-commerce mobile très exposé à Safari et un SaaS B2B générant surtout des conversions CRM différées n’ont pas les mêmes priorités.
Les sources de perte doivent être séparées. La première vient des restrictions navigateurs. Safari, via ITP, Intelligent Tracking Prevention, limite fortement la persistance de certains identifiants client-side, notamment lorsque les cookies sont déposés par JavaScript ou associés à des domaines considérés comme traçants. Firefox applique également des mécanismes de protection contre le tracking. Chrome évolue vers un environnement où les cookies tiers sont moins fiables et où les signaux agrégés prennent plus de place. Sur certains comptes, la durée de reconnaissance effective d’un utilisateur peut passer de plusieurs semaines à quelques jours, voire moins selon la configuration technique.
La deuxième source est l’ad blocking. Selon les secteurs, les pays et les devices, les bloqueurs peuvent concerner de 10 % à plus de 35 % des sessions desktop. Le chiffre est souvent plus faible sur mobile, mais il varie fortement selon l’audience. Un public technique, finance, crypto, gaming ou B2B software peut être beaucoup plus équipé que la moyenne. Le server-side peut réduire l’impact de certains blocages, notamment lorsque les événements sont envoyés depuis un sous-domaine first-party, mais il ne rend pas la mesure invisible ni universelle. Certains appels peuvent encore être filtrés, et les obligations de consentement restent applicables.
La troisième source est le consentement. En Europe, le RGPD, règlement général sur la protection des données encadrant la collecte et l’usage des données personnelles, et les lignes directrices ePrivacy imposent de respecter les finalités acceptées ou refusées par l’utilisateur. Si 40 % des visiteurs refusent la finalité publicitaire, le server-side ne doit pas être utilisé pour transmettre ces événements à des plateformes d’activation publicitaire comme si le consentement existait. Il peut servir à mieux contrôler ce qui est envoyé, à supprimer des paramètres, à limiter les finalités ou à produire une mesure agrégée conforme, mais pas à effacer la décision de l’utilisateur.
La quatrième source est la mauvaise qualité du tracking existant. Beaucoup de pertes attribuées aux navigateurs viennent en réalité de plans de taggage instables : événements déclenchés deux fois, conversions non dédupliquées, montants de commande incohérents entre analytics et backend, UTM écrasés, consent mode mal paramétré, erreurs JavaScript, tags chargés trop tard, pixels supprimés lors d’une refonte. Dans ce cas, le server-side ne résout pas le problème. Il industrialise parfois une mauvaise donnée. Avant toute migration, un audit doit comparer les volumes par événement entre navigateur, analytics, plateforme publicitaire, backend transactionnel et CRM.
Un diagnostic utile consiste à construire une matrice des événements selon deux axes : valeur décisionnelle et fragilité de mesure. Un achat payé, un lead qualifié, une activation SaaS ou une création de pipeline ont une forte valeur décisionnelle. Un scroll, une vue vidéo ou un clic secondaire en ont moins. Si un événement est à forte valeur et fortement fragile, il devient candidat à une architecture server-side. Si un événement est faible et fragile, il vaut souvent mieux le supprimer du dashboard que le migrer.
Comprendre ce que le server-side améliore vraiment, et ce qu’il ne corrige pas
Le tracking server-side améliore principalement le contrôle. L’entreprise peut recevoir un événement depuis le navigateur, le serveur applicatif, le backend e-commerce, le CRM ou un système de paiement, puis décider ce qui est transmis à chaque destination. Ce contrôle permet de normaliser les noms d’événements, d’ajouter des propriétés fiables, de supprimer des données inutiles, de gérer la déduplication, de contrôler la latence et d’appliquer des règles de consentement plus cohérentes.
Prenons un exemple e-commerce. En client-side classique, le navigateur envoie un événement purchase à l’outil analytics, au pixel social, à la plateforme d’affiliation et à un outil CRO. Si la page de confirmation est rechargée, si le script se déclenche deux fois ou si l’utilisateur revient depuis un email de confirmation, certains systèmes peuvent compter deux conversions. En server-side, l’événement d’achat peut être déclenché depuis le backend lorsque le paiement est réellement validé, avec un order_id unique, un montant net, une devise, une marge estimée et un statut de consentement. Les destinations reçoivent un événement plus propre, et la déduplication devient plus robuste.
Le server-side peut aussi améliorer le matching publicitaire. Les API de conversion, comme les conversions API des plateformes sociales ou les enhanced conversions des moteurs de recherche, utilisent des signaux first-party, c’est-à-dire des données collectées directement par l’entreprise auprès de ses visiteurs ou clients, souvent hachées avant transmission. L’objectif est d’aider la plateforme à relier une conversion à une exposition publicitaire lorsque les cookies ou identifiants classiques sont insuffisants. Une meilleure correspondance peut améliorer l’optimisation des campagnes, notamment en RTB, real-time bidding, mécanisme d’enchères en temps réel permettant d’acheter une impression publicitaire disponible, et via les DSP, demand-side platforms, plateformes permettant aux annonceurs d’acheter des impressions programmatiques.
Mais cette amélioration n’est pas une preuve d’incrémentalité. Si une plateforme retrouve davantage de conversions attribuables, le ROAS affiché peut augmenter sans que les ventes totales progressent. L’attribution devient plus complète, pas nécessairement plus causale. Une équipe marketing doit donc distinguer trois notions : conversions observées, conversions attribuées et conversions incrémentales. Le server-side agit surtout sur les deux premières. Pour mesurer la troisième, il faut des holdouts, groupes témoins volontairement exclus d’une exposition ou d’une action, des tests géographiques, des tests d’incrémentalité média ou des modèles économétriques selon le niveau de maturité.
Le server-side ne corrige pas non plus un mauvais modèle de données. Si l’événement lead_submit mélange une demande commerciale qualifiée, un téléchargement de contenu et une inscription newsletter, le serveur transmettra une donnée plus fiable techniquement mais toujours ambiguë. Si l’entreprise ne distingue pas revenu brut, marge nette, remboursement, annulation et valeur vie client, la précision d’envoi ne compensera pas la faiblesse du KPI. La qualité de la mesure dépend d’abord de la définition des événements, ensuite de l’architecture de transport.
Enfin, le server-side peut introduire une latence analytique. Certains événements backend sont plus fiables mais moins immédiats. Une transaction peut être validée après antifraude, un lead peut devenir SQL, sales qualified lead, lead accepté par les ventes comme opportunité potentielle, plusieurs jours plus tard, une activation SaaS peut être connue après une séquence d’usage. Cette latence est saine si elle rapproche la mesure de la valeur réelle. Elle devient problématique si les plateformes d’enchères ont besoin d’un signal rapide pour optimiser. L’arbitrage consiste donc à envoyer un signal précoce mais pondéré, puis un signal de qualité plus tardif, plutôt que de tout optimiser sur une micro-conversion rapide.
Évaluer le gain business : précision additionnelle, qualité d’optimisation et coût de preuve
Le passage au server-side doit être justifié économiquement. Un gain de mesure n’a de valeur que s’il améliore une décision : allocation budgétaire, arbitrage canal, priorisation CRO, stratégie d’enchère, scoring de leads ou pilotage de marge. La question n’est pas de savoir combien de conversions supplémentaires seront visibles, mais combien de décisions seront meilleures grâce à cette visibilité.
Un cadre utile consiste à estimer la valeur du signal récupéré. Supposons un e-commerce générant 2 millions d’euros de chiffre d’affaires mensuel en ligne, avec 600 000 euros de dépenses média. Les plateformes publicitaires reportent 1,1 million d’euros de revenu attribué. Après audit, l’équipe estime que 12 % des achats payés ne sont pas transmis correctement aux plateformes à cause d’un mélange d’ad blocking, de consentement mal propagé et de tags client-side instables. Si une architecture server-side permet de récupérer proprement la moitié de cette perte mesurable, le reporting pourrait afficher environ 66 000 euros de revenu attribué additionnel par mois. Mais ce chiffre ne dit pas encore si l’entreprise gagne plus d’argent.
Le gain potentiel vient plutôt de l’optimisation algorithmique. Si les campagnes reçoivent davantage de conversions fiables, les modèles d’enchères peuvent mieux identifier les profils rentables, réduire le CPA ou augmenter le ROAS sur les segments où le signal manquait. Dans certains cas, on observe une amélioration de 5 % à 15 % du coût par conversion attribuée après stabilisation, mais ces ordres de grandeur dépendent fortement du volume, de la qualité des événements et du niveau initial de perte. Un compte déjà bien mesuré gagnera peu. Un compte très fragmenté peut gagner davantage, mais aussi révéler que certains canaux étaient sous-attribués plutôt que sous-performants.
Il faut aussi intégrer le coût de preuve. Pour savoir si le server-side améliore réellement la performance, il ne suffit pas de comparer le ROAS avant et après migration. La période peut coïncider avec une saisonnalité, une promotion, une hausse de budget, une modification créative ou un changement concurrentiel. Une méthode plus rigoureuse consiste à déployer progressivement : par pays, par domaine, par catégorie ou par ensemble de campagnes. On peut comparer les campagnes avec API de conversion activée et celles conservées temporairement en configuration standard, en contrôlant les budgets, les créations et le mix d’audience.
Pour les volumes élevés, un test géographique peut être pertinent. Une enseigne drive-to-store, c’est-à-dire visant à générer des visites en point de vente depuis des actions digitales, peut activer une meilleure remontée server-side dans plusieurs régions comparables, puis mesurer les écarts de visites, ventes caisse ou conversions CRM. Ce type de protocole demande plus d’effort qu’un simple dashboard, mais il évite de confondre amélioration de matching et hausse réelle de demande.
Le framework RICE, reach, impact, confidence, effort, peut être adapté au server-side. Le reach correspond au volume d’événements concernés. L’impact mesure la valeur économique attendue d’une meilleure mesure. La confidence reflète la qualité du diagnostic initial : écarts backend, logs, taux d’ad blocking, taux de consentement, erreurs de taggage. L’effort inclut intégration, maintenance, QA, sécurité, juridique et monitoring. Un événement purchase à fort volume aura souvent un score élevé. Un clic sur une FAQ produit aura rarement un score suffisant pour justifier une migration prioritaire.
Arbitrer l’architecture : passerelle de tags, backend natif ou pipeline data
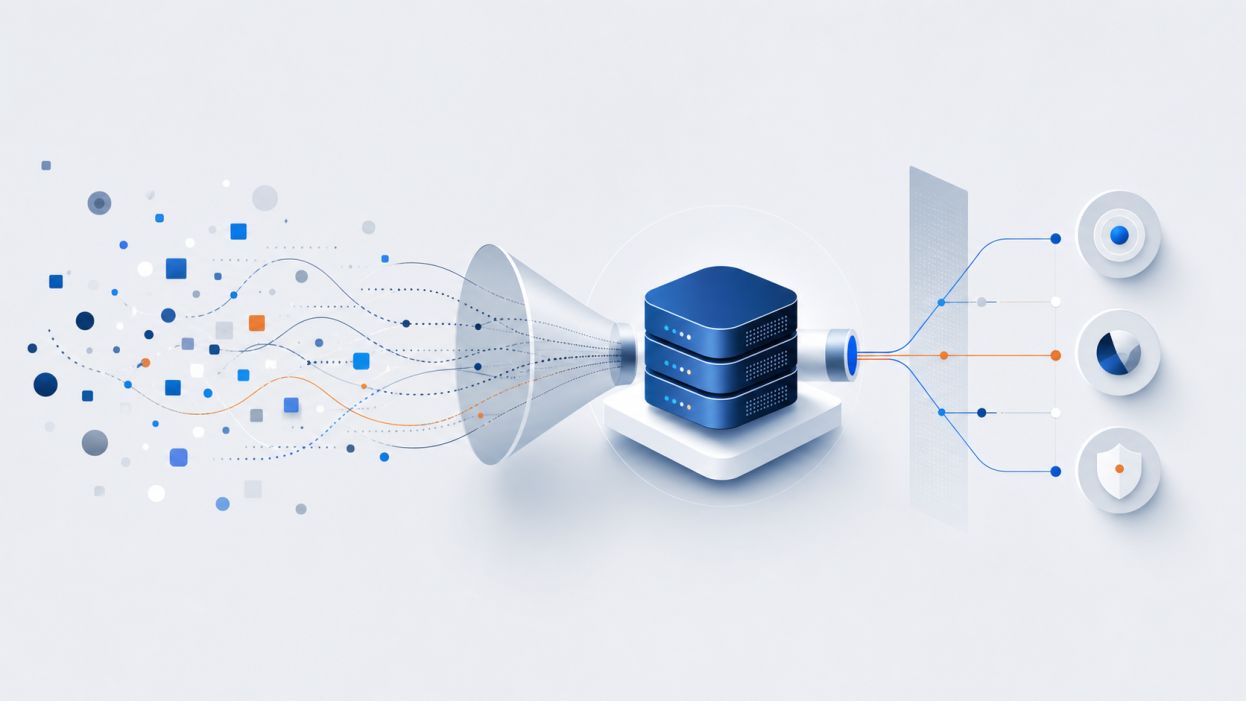
Il existe plusieurs façons de mettre en place du tracking server-side, et elles ne répondent pas aux mêmes besoins. La première approche est la passerelle de tags server-side. Elle consiste à utiliser un conteneur serveur, souvent exposé sur un sous-domaine first-party, qui reçoit les événements du navigateur puis les redistribue vers les destinations. Cette solution est relativement rapide à déployer, compatible avec beaucoup de stacks marketing et utile pour reprendre le contrôle sur les scripts tiers. Elle reste toutefois dépendante d’un signal initial souvent déclenché côté navigateur. Si l’événement client-side ne part pas, arrive trop tard ou n’est pas autorisé, le serveur ne peut pas l’inventer légitimement.
La deuxième approche est l’envoi backend natif. Les événements critiques sont générés par les systèmes métier : plateforme e-commerce, serveur applicatif, CRM, outil de paiement, ERP ou data warehouse. C’est souvent la meilleure option pour les conversions à forte valeur : achat payé, abonnement activé, remboursement, lead qualifié, opportunité créée. Elle améliore la cohérence avec la réalité business. En revanche, elle demande une collaboration étroite entre marketing, data engineering, produit et juridique. Elle nécessite aussi une gestion précise des identifiants, car un événement backend doit être relié à une session, une campagne ou une exposition publicitaire sans violer les règles de consentement.
La troisième approche est le pipeline data. Les événements sont collectés dans une infrastructure centrale, enrichis, validés, puis envoyés vers analytics, BI, CRM et plateformes média. Cette architecture convient aux organisations avancées qui veulent un modèle de données unifié. Elle permet de gérer des règles complexes : filtrage par finalité de consentement, mapping des événements, calcul de valeur prédictive, envoi différé de signaux de qualité, rapprochement avec les retours produit ou la marge. Son inconvénient est le coût : compétences data, supervision, contrats de sous-traitance, gestion des incidents et documentation.
Le choix dépend du niveau de criticité. Pour un site dont l’objectif est surtout de fiabiliser les achats et d’améliorer les conversions API, une passerelle server-side bien configurée et quelques événements backend peuvent suffire. Pour un SaaS B2B où la valeur réelle apparaît dans le CRM plusieurs semaines après le lead, il faut probablement un pipeline reliant acquisition, site, marketing automation, CRM et facturation. Pour un retailer omnicanal, la complexité vient du rapprochement entre exposition digitale, compte client, visite magasin et vente caisse ; le tracking server-side n’est alors qu’une brique d’une architecture d’identité et de mesure plus large.
La gestion des identifiants est le point critique. Un événement peut contenir un client_id analytics, un user_id interne, un email haché, un click_id publicitaire, un order_id et des paramètres UTM. Chacun a une finalité, une durée de conservation et un niveau de sensibilité différents. Il faut éviter deux excès : envoyer trop peu d’identifiants et perdre la capacité de matching ; envoyer trop de données et augmenter inutilement le risque juridique. Une bonne pratique consiste à définir, destination par destination, les champs autorisés, obligatoires, optionnels et interdits.
La déduplication doit être pensée dès le départ. Si le même achat est envoyé à la fois par pixel client-side et par API server-side, les plateformes doivent recevoir un event_id commun pour reconnaître qu’il s’agit de la même conversion. Sinon, les conversions peuvent être doublées. À l’inverse, une déduplication trop agressive peut supprimer des événements légitimes, par exemple deux commandes distinctes passées par le même utilisateur en quelques minutes. Le QA doit inclure des scénarios concrets : rechargement de page, paiement échoué puis réussi, achat multi-device, consentement changé en cours de session, commande annulée, remboursement partiel.
Traiter la conformité comme une contrainte de design, pas comme une validation finale
Le server-side est parfois présenté comme une réponse aux limites du client-side. Cette formulation peut devenir dangereuse si elle suggère que le serveur permet de contourner les choix de l’utilisateur ou les règles des navigateurs. En Europe, la conformité doit être intégrée dès la conception. Le fait qu’un événement transite par un serveur contrôlé par l’entreprise ne supprime pas les obligations relatives au consentement, à l’information, à la minimisation, à la sécurité et aux transferts hors UE.
Le premier principe est la finalité. Une même donnée ne doit pas être envoyée indifféremment à toutes les destinations. Un événement purchase peut être nécessaire à la mesure interne de performance, utile à l’analytics, et soumis à consentement pour l’activation publicitaire selon les paramètres et les pays. Le serveur doit donc appliquer une logique de routage par finalité : mesure d’audience, personnalisation, publicité, CRM, sécurité, support. Cette logique doit être synchronisée avec la CMP, consent management platform, outil qui recueille et transmet les choix de consentement des utilisateurs.
Le deuxième principe est la minimisation. Le server-side facilite l’enrichissement des événements, mais tout enrichissement n’est pas légitime. Envoyer un email haché, un numéro de téléphone haché, une adresse IP complète, un user-agent, un click_id, un panier détaillé et un score CRM à plusieurs plateformes augmente la surface de risque. La question doit être posée destination par destination : ce champ est-il nécessaire pour la finalité déclarée ? Peut-il être supprimé, tronqué, agrégé, pseudonymisé ou remplacé par un identifiant moins sensible ?
Le troisième principe est la traçabilité. Une architecture server-side mature doit produire des logs exploitables : événements reçus, événements bloqués, destinations appelées, règles de consentement appliquées, erreurs API, taux de déduplication, temps de traitement. Ces logs ne doivent pas conserver indéfiniment des données personnelles, mais ils sont nécessaires pour auditer le système. Sans journalisation, l’entreprise ne peut pas prouver qu’elle respecte ses propres règles.
Le quatrième principe concerne les transferts et sous-traitants. Les plateformes publicitaires et analytics peuvent impliquer des transferts de données ou des traitements soumis à contrats, clauses spécifiques et analyses d’impact. Le server-side ne réduit pas mécaniquement ces enjeux. Il peut même les rendre plus visibles, car l’entreprise décide activement de ce qui est transmis. Une revue juridique doit couvrir les destinataires, les pays de traitement, les durées de conservation, les bases légales, les mécanismes de sécurité et les droits utilisateurs.
Dans certains cas, une DPIA, data protection impact assessment, analyse d’impact relative à la protection des données, peut être nécessaire, notamment si le dispositif combine plusieurs sources d’identité, scoring, données CRM et activation publicitaire. Le marketing ne doit pas voir cette étape comme un frein bureaucratique. Elle oblige à expliciter les risques et à réduire la collecte aux signaux réellement utiles. Une architecture plus sobre est souvent plus robuste, plus facile à maintenir et plus défendable.
Calculer le coût total : infrastructure, maintenance, QA et dette organisationnelle
Le coût du tracking server-side ne se limite pas à l’abonnement d’un outil ou à l’hébergement d’un conteneur. Il faut raisonner en TCO, total cost of ownership, coût total de possession sur la durée. Les dépenses visibles incluent l’infrastructure serveur, les appels API, les connecteurs, les environnements de test, les éventuelles licences et le support. Les dépenses moins visibles incluent le temps des équipes data, dev, analytics, juridique, acquisition et CRM.
Un déploiement minimal peut coûter quelques centaines à quelques milliers d’euros par mois en infrastructure et outillage. Un dispositif avancé reliant site, backend, CRM, data warehouse et plateformes média peut représenter plusieurs dizaines de milliers d’euros de coût initial, puis une charge récurrente importante. Le coût est justifiable si les événements critiques génèrent suffisamment de valeur. Il l’est beaucoup moins si l’entreprise migre une longue liste d’interactions peu décisionnelles simplement parce qu’elles existent dans le plan de taggage.
Le QA est l’un des postes les plus sous-estimés. Chaque événement doit être testé selon plusieurs environnements : desktop, mobile, Safari, Chrome, navigation privée, ad blocker, consentement accepté, refusé, partiel, utilisateur connecté, invité, paiement réussi, paiement échoué. Il faut vérifier les écarts entre événements reçus serveur, événements envoyés aux plateformes et événements visibles dans les interfaces. Un écart de 3 % peut être acceptable selon le contexte. Un écart de 20 % doit être investigué avant d’utiliser les données pour piloter les budgets.
La maintenance est continue. Les API changent, les plateformes modifient leurs paramètres recommandés, les pages évoluent, les modèles de consentement sont mis à jour, les nomenclatures produits changent, les règles CRM s’affinent. Un tracking server-side sans propriétaire clair devient rapidement une boîte noire. Il faut un owner analytics, un owner technique, un owner juridique et des procédures d’incident. Si une API de conversion cesse d’accepter un champ, qui le détecte ? Si le taux de matching chute de 35 % à 18 %, qui enquête ? Si une nouvelle campagne envoie des UTM non conformes, qui corrige ?
La dette organisationnelle apparaît lorsque le server-side donne une impression de fiabilité absolue. Les équipes peuvent arrêter de challenger les dashboards, oublier les limites d’attribution ou multiplier les événements en pensant que le serveur les rend propres par défaut. La gouvernance doit rappeler que la mesure reste un modèle. Elle est plus contrôlée, pas parfaite. Les dashboards doivent continuer à distinguer données observées, données modélisées, données attribuées et données incrémentales.
Un indicateur utile est le ratio valeur du signal sur coût de maintien. Si un événement est consulté chaque semaine, influence des budgets importants et possède une définition stable, il mérite une maintenance forte. Si un événement n’est jamais utilisé dans une décision, il doit être supprimé ou relégué aux logs. La sobriété est une stratégie de performance : moins d’événements, mieux définis, mieux testés, mieux reliés à la valeur.
Mettre en place un protocole de déploiement progressif et mesurable
Un bon déploiement server-side commence par un périmètre limité. Il est préférable de migrer cinq événements critiques correctement que cinquante événements superficiels approximativement. Les candidats prioritaires sont généralement : page_view enrichi de consentement, lead_submit qualifié, purchase validé, refund ou cancellation, signup activé, SQL créé, abonnement payant. Chaque événement doit avoir une fiche de définition : déclencheur exact, source de vérité, propriétés obligatoires, règles de consentement, destinations, méthode de déduplication, owner et tests de validation.
La première phase doit être passive. Pendant deux à quatre semaines, le serveur peut recevoir et comparer les événements sans modifier immédiatement l’optimisation média. L’objectif est de mesurer les écarts : combien d’achats backend ne sont pas vus par l’analytics ? Combien d’événements client-side n’ont pas de correspondance serveur ? Quels devices sont sous-représentés ? Le consentement est-il correctement transmis ? Les montants correspondent-ils au backend ? Cette phase évite de brancher des algorithmes d’enchères sur un signal non stabilisé.
La deuxième phase consiste à activer une destination à la fois. Par exemple, commencer par envoyer les purchases server-side à l’analytics interne, puis à une plateforme publicitaire avec déduplication, puis au CRM. À chaque étape, l’équipe doit suivre des métriques de santé : taux d’événements reçus, taux d’événements envoyés, taux d’erreur API, taux de matching, taux de déduplication, latence médiane et p95, écarts de revenu, écarts par navigateur et par consentement. Un monitoring sans seuils d’alerte est insuffisant. Il faut définir à l’avance ce qui déclenche une investigation.
La troisième phase est l’évaluation business. Si l’objectif est d’améliorer l’optimisation média, il faut comparer les campagnes de manière contrôlée. Les budgets doivent rester suffisamment stables, les créations ne doivent pas changer simultanément, et les résultats doivent être lus par canal. Une amélioration globale peut masquer une hausse sur paid search marque, achat de liens sponsorisés sur des requêtes associées à la marque, et une baisse sur paid social prospecting, campagnes sociales visant des audiences froides. La lecture doit intégrer CPA, ROAS, marge, volume de conversions, qualité downstream et incrémentalité lorsque possible.
La quatrième phase est la documentation. Chaque événement server-side doit être intégré au dictionnaire de données. Chaque changement doit être historisé. Les équipes acquisition doivent savoir quelles conversions sont envoyées aux plateformes, avec quelle valeur et sous quelles conditions. Les équipes CRO doivent savoir si leurs tests utilisent des conversions client-side, backend ou hybrides. Les équipes juridiques doivent savoir quelles finalités déclenchent quels flux. Sans documentation partagée, le server-side devient un avantage technique fragile plutôt qu’un actif analytique.
Enfin, il faut maintenir des audits réguliers. Un audit trimestriel peut vérifier la cohérence analytics-backend, les taux de consentement, les paramètres envoyés, les erreurs API, les évolutions de nomenclature et les événements inutilisés. Un audit plus léger peut être automatisé chaque semaine sur les métriques de santé. La mesure est un système vivant : elle se dégrade naturellement si personne ne la surveille.
Conclusion : arbitrer le server-side comme un investissement de décision, pas comme un projet de tags
Le tracking server-side peut améliorer la précision de la mesure, renforcer la qualité des signaux transmis aux plateformes et réduire certaines dépendances au navigateur. Mais il n’est ni une garantie de performance, ni une échappatoire au consentement, ni une preuve d’incrémentalité. Sa valeur dépend de la qualité des événements, de la gouvernance, du protocole de mesure et de la capacité de l’organisation à transformer un meilleur signal en meilleures décisions.
Une méthode actionnable tient en huit étapes. Premièrement, auditer les pertes de signal existantes en séparant navigateurs, ad blocking, consentement et erreurs de taggage. Deuxièmement, prioriser les événements selon leur valeur décisionnelle et leur fragilité de mesure. Troisièmement, choisir l’architecture adaptée : passerelle de tags, backend natif ou pipeline data. Quatrièmement, définir les identifiants, les champs autorisés, les règles de déduplication et les destinations par finalité. Cinquièmement, intégrer la conformité dès le design : consentement, minimisation, logs, sous-traitants et transferts. Sixièmement, calculer le coût total, y compris QA, maintenance et gouvernance. Septièmement, déployer progressivement avec une phase passive, des métriques de santé et des seuils d’alerte. Huitièmement, évaluer l’impact business avec des protocoles contrôlés, pas seulement avec une comparaison avant-après.
Pour les professionnels du marketing, la décision doit rester économique et analytique. Si le server-side permet de fiabiliser les conversions qui pilotent plusieurs centaines de milliers d’euros de budget, il peut devenir un levier stratégique. Si l’objectif est de récupérer quelques micro-conversions sans lien clair avec la marge, il risque de créer une complexité coûteuse. La maturité consiste à accepter un principe simple : plus la donnée influence des décisions importantes, plus son architecture mérite d’être robuste, documentée et conforme.
Le bon arbitrage n’est donc pas entre client-side et server-side de manière abstraite. Il est entre précision utile, coût supportable et conformité démontrable. Un tracking server-side réussi ne cherche pas à tout mesurer. Il cherche à mieux mesurer ce qui change réellement l’allocation des budgets, la lecture du funnel et la compréhension de la valeur client.